La ciencia de datos cambia deprisa, y desde la llegada de la IA generativa más todavía. Esta es nuestra lista actualizada de las tendencias que ya están transformando el trabajo con datos y las que se consolidarán en los próximos meses.
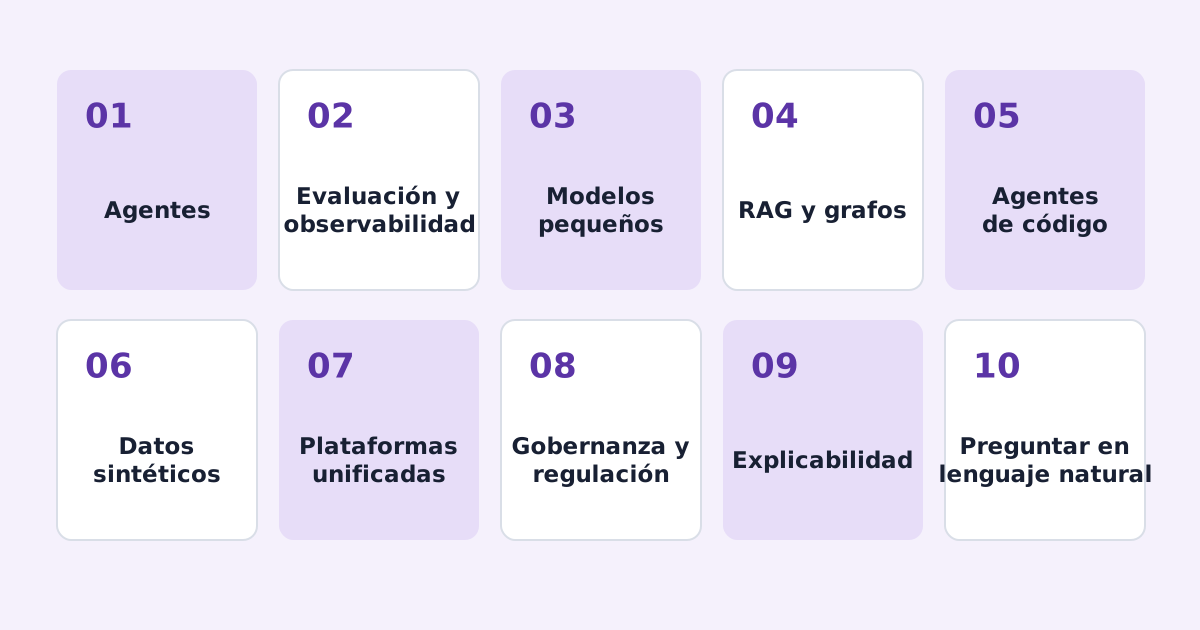
1. De los modelos a los agentes
El salto más visible: sistemas que no solo responden, sino que actúan. Un agente recibe un objetivo, planifica los pasos, usa herramientas (consultar una base de datos, ejecutar código, buscar en documentos) y revisa el resultado. El Model Context Protocol (MCP) se ha convertido en una forma estándar de conectar agentes con herramientas y fuentes de datos. Para quien trabaja con datos, significa diseñar qué puede hacer el agente, con qué permisos y cómo comprobar que lo ha hecho bien.
2. Evaluación y observabilidad de sistemas de IA
Con modelos generativos no basta con una métrica de exactitud. Las empresas que llevan IA a producción construyen conjuntos de evaluación propios, usan modelos como jueces automáticos, revisan muestras con personas y registran trazas de cada paso para detectar fallos y medir coste y latencia. Evaluar bien se ha convertido en una de las habilidades más demandadas.
3. Modelos más pequeños y eficientes
No todo necesita el modelo más grande. La cuantización, la destilación y los modelos abiertos de tamaño medio permiten ejecutar IA con menos coste, en servidores propios o incluso en el dispositivo, cuando la privacidad o la latencia lo exigen. Elegir el modelo adecuado para cada tarea es ya una decisión económica.
4. RAG maduro y grafos de conocimiento
Los sistemas que responden preguntas sobre documentos propios mediante recuperación (RAG) han pasado de prototipo a producción. Las mejoras se centran en cómo trocear los documentos, en reordenar los resultados y en combinar búsqueda vectorial con grafos de conocimiento (GraphRAG) para preguntas que requieren relacionar información.
5. Agentes de código en el trabajo diario
Los agentes de código escriben consultas, transformaciones de datos, pruebas y documentación. El trabajo se desplaza de escribir código a especificar bien la tarea y revisar el resultado.
6. Datos sintéticos
Generar datos artificiales que imitan a los reales permite entrenar y probar modelos sin exponer información sensible, equilibrar clases poco representadas o crear casos de prueba para evaluar sistemas de IA. Su riesgo: reproducir o amplificar los sesgos de los datos de origen si no se validan.
7. Plataformas de datos unificadas
Las arquitecturas lakehouse y los formatos de tabla abiertos, como Apache Iceberg o Delta Lake, permiten usar los mismos datos para análisis, aprendizaje automático e IA generativa sin copiarlos entre sistemas. A esto se suma la capa semántica, que define una sola vez qué significa cada métrica para que personas y agentes la calculen igual.
8. Gobernanza y regulación
El Reglamento Europeo de IA está en vigor desde agosto de 2024 y se aplica de forma escalonada. El ómnibus digital aprobado en 2026 retrasó las obligaciones de los sistemas de alto riesgo a diciembre de 2027 para los del anexo III y a agosto de 2028 para los ligados a productos regulados. Junto al RGPD, obliga a documentar los datos, gestionar riesgos y garantizar supervisión humana, y eso exige perfiles que entiendan a la vez la técnica y la norma.
9. La explicabilidad sigue siendo necesaria
En crédito, seguros, salud o recursos humanos hay que poder explicar por qué un modelo decide lo que decide. Técnicas como SHAP o LIME siguen vigentes para los modelos clásicos, y en los modelos generativos se exige trazabilidad: qué documentos usó, qué herramientas llamó y por qué.
10. Preguntar a los datos en lenguaje natural
Las herramientas que traducen preguntas en lenguaje natural a SQL o a gráficos acercan el análisis a quien no programa. El reto es la fiabilidad: sin una capa semántica bien definida y sin validación, dan respuestas convincentes pero erróneas.
Lo que se queda fuera
La computación cuántica sigue apareciendo en las listas de tendencias, pero sus aplicaciones prácticas a la ciencia de datos son todavía muy limitadas. AutoML, protagonista de hace unos años, ha quedado integrado en las plataformas y en los asistentes, más que como una tendencia propia.
Qué aprender para seguir el ritmo
- Fundamentos sólidos: estadística, Python, SQL y aprendizaje automático.
- Modelos de lenguaje: instrucciones, contexto, RAG y adaptación.
- Agentes, uso de herramientas y MCP.
- Evaluación, seguridad y observabilidad de sistemas de IA.
- Despliegue y control de costes.
- Regulación y uso responsable de la IA.