Cuando una empresa quiere usar un modelo de lenguaje (LLM) para un caso concreto, como un asistente para la normativa interna, un clasificador de incidencias o un generador de informes, enseguida surge la pregunta: ¿basta con escribir buenas instrucciones, hay que conectarlo a nuestros documentos o hay que entrenarlo? Son tres técnicas distintas: prompting, RAG y fine-tuning. Elegir bien ahorra meses y dinero.
La respuesta corta
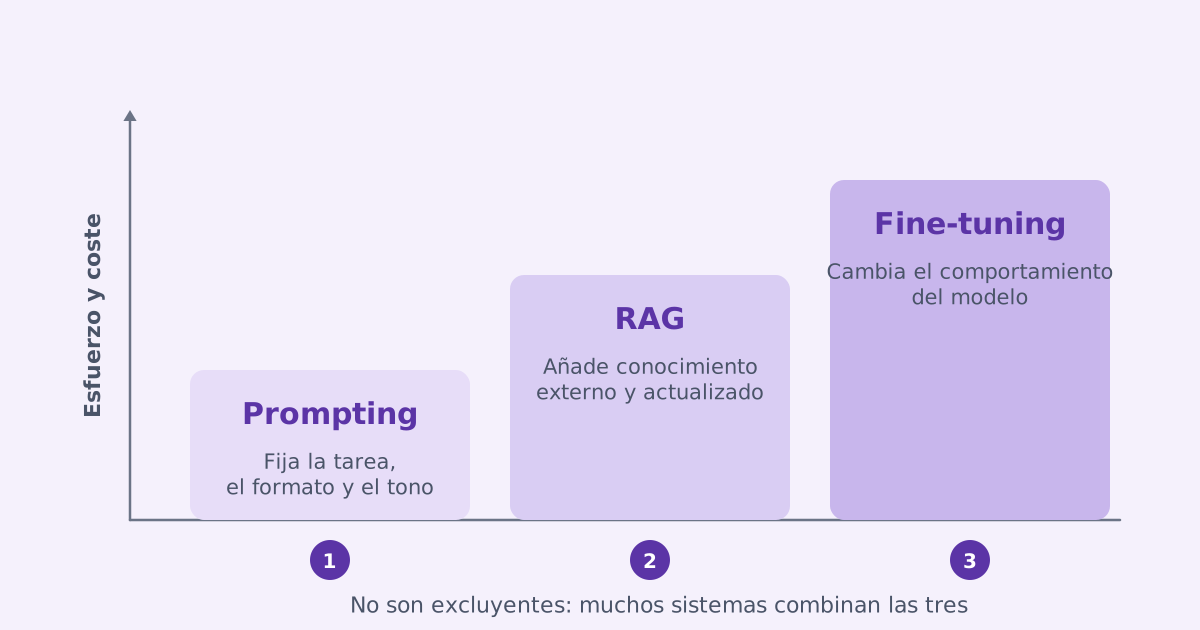
- Prompting: para fijar la tarea, el formato y el tono. Siempre es el primer paso.
- RAG: cuando el modelo necesita conocimiento que no tiene o que cambia: documentos internos, normativa, catálogos.
- Fine-tuning: cuando necesitas cambiar el comportamiento del modelo de forma consistente, o usar un modelo más pequeño y barato para una tarea muy concreta.
No son excluyentes: muchos sistemas en producción combinan las tres.
Prompting e ingeniería de contexto
Consiste en diseñar las instrucciones y el contexto que recibe el modelo: el rol, la tarea, ejemplos de entrada y salida, restricciones y el formato de respuesta. Hoy se habla de ingeniería de contexto porque no se trata solo de redactar una frase, sino de decidir qué información ve el modelo en cada llamada.
Cuándo basta: tareas generales que el modelo ya sabe hacer, como resumir, redactar, clasificar en categorías sencillas o extraer campos de un texto.
Límites: el modelo no sabe nada que no esté en su entrenamiento o en el contexto, y las instrucciones muy largas encarecen cada consulta.
RAG: recuperación de información
RAG (Retrieval-Augmented Generation) conecta el modelo con una base de conocimiento. Antes de responder, el sistema busca los fragmentos de documentos más relevantes para la pregunta y se los pasa al modelo como contexto. El proceso tiene varias piezas:
- Trocear los documentos en fragmentos manejables.
- Calcular sus embeddings, vectores que representan el significado.
- Indexarlos en una base de datos vectorial o en un buscador.
- Ante cada pregunta, recuperar los fragmentos más parecidos y, a menudo, reordenarlos con un modelo más preciso.
- Generar la respuesta con esos fragmentos, idealmente citando de dónde sale cada dato.
Cuándo conviene: conocimiento propio o que cambia a menudo, necesidad de citar fuentes, respetar permisos de acceso a documentos.
Límites: si la recuperación falla, el modelo responde con información incorrecta o incompleta. La calidad depende mucho de cómo se trocea, se indexa y se busca.
Fine-tuning: ajustar el modelo
El fine-tuning entrena el modelo con ejemplos propios para modificar su comportamiento. Las técnicas más usadas hoy:
- SFT (Supervised Fine-Tuning): ejemplos de entrada y respuesta deseada.
- LoRA y QLoRA, de la familia PEFT: entrenan solo una pequeña parte de los parámetros, lo que reduce mucho el coste y la memoria necesaria.
- Optimización de preferencias, como RLHF o DPO: enseñan al modelo qué respuestas se prefieren frente a otras.
Cuándo conviene: un formato o estilo muy específico que el prompting no consigue de forma fiable, tareas especializadas con mucho volumen en las que un modelo pequeño ajustado sustituye a uno grande y caro, o vocabulario muy técnico de un dominio.
Límites: hace falta un conjunto de datos de calidad, el modelo resultante hay que evaluarlo y mantenerlo, y no es una buena forma de "meter" conocimiento que cambia.
Comparativa
| Prompting | RAG | Fine-tuning | |
|---|---|---|---|
| Qué cambia | Las instrucciones | El conocimiento disponible | El comportamiento del modelo |
| Esfuerzo inicial | Bajo | Medio | Alto |
| Coste por consulta | Sube con instrucciones largas | Algo mayor por la búsqueda | Puede bajar con un modelo más pequeño |
| Actualizar información | Editar el prompt | Reindexar documentos | Volver a entrenar |
| Cita fuentes | No | Sí | No |
| Riesgo principal | Instrucciones frágiles | Recuperación deficiente | Datos de entrenamiento pobres |
Cómo decidir: midiendo
La clave no es la intuición, sino un conjunto de evaluación: un centenar de preguntas o casos reales con la respuesta esperada. Con él:
- Empieza con prompting y mide.
- Si los fallos se deben a falta de información, añade RAG y vuelve a medir.
- Si los fallos se deben al comportamiento (formato, estilo, criterio) o el coste es demasiado alto, valora el fine-tuning.
- Mantén la evaluación cuando el sistema esté en producción: los documentos, los usuarios y los modelos cambian.
Tres ejemplos
- Asistente sobre la normativa interna de una empresa: RAG, porque la normativa cambia y hay que citar el artículo de donde sale cada respuesta.
- Clasificar miles de incidencias diarias en categorías propias: fine-tuning de un modelo pequeño, más barato y rápido que llamar a un modelo grande cada vez.
- Redactar respuestas a clientes con el tono de la marca: prompting con buenos ejemplos y, si no basta, un ajuste fino de estilo.