Scikit-learn es la librería de Python de referencia para el aprendizaje automático clásico: clasificación, regresión, agrupamiento y reducción de dimensionalidad. Es gratuita, está muy bien documentada y todos sus modelos se usan de la misma forma, lo que la convierte en el mejor punto de partida para aprender machine learning.
En este artículo explicamos qué incluye y, sobre todo, cómo entrenar, evaluar, ajustar y guardar tu primer modelo con un ejemplo completo.
Qué es scikit-learn
Scikit-learn nació en 2007 como un proyecto de Google Summer of Code y hoy lo mantiene una amplia comunidad. Está construida sobre NumPy y SciPy, se integra con pandas y se publica con licencia libre BSD.
Su gran acierto es una interfaz común. Casi todo en scikit-learn es un estimador con dos métodos:
fit()para aprender de los datos.predict()para predecir, otransform()para transformar datos.
Si sabes usar un modelo, sabes usarlos todos.
Qué incluye
- Clasificación: regresión logística, árboles de decisión, random forest, gradient boosting, máquinas de vectores soporte, k vecinos más cercanos.
- Regresión: lineal, ridge, lasso, árboles y ensembles.
- Agrupamiento: k-means, DBSCAN, clustering jerárquico.
- Reducción de dimensionalidad: PCA y otras técnicas.
- Preprocesado: escalado, codificación de variables categóricas, imputación de valores que faltan.
- Selección de modelos: separación de datos, validación cruzada, búsqueda de hiperparámetros y métricas.
Tu primer modelo, paso a paso
Usaremos un conjunto de datos que trae la propia librería: medidas de tumores de mama clasificados como benignos o malignos.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

# 1. Cargar los datos como DataFrame de pandas
X, y = load_breast_cancer(return_X_y=True, as_frame=True)

# 2. Separar entrenamiento y prueba
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# 3. Definir el modelo: escalar las variables y aplicar regresión logística
modelo = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))

# 4. Entrenar y evaluar con datos que el modelo no ha visto
modelo.fit(X_train, y_train)
print(classification_report(y_test, modelo.predict(X_test)))
El informe muestra la precisión, la exhaustividad (recall) y la F1 para cada clase. Mirar solo la exactitud global puede engañar cuando una clase es mucho más frecuente que la otra.
Validación cruzada
Una sola separación entre entrenamiento y prueba puede salir con suerte. La validación cruzada repite el proceso con varias particiones y da una estimación más fiable:
from sklearn.model_selection import cross_val_score

puntuaciones = cross_val_score(modelo, X, y, cv=5, scoring="f1")
print(f"F1 medio: {puntuaciones.mean():.3f} ± {puntuaciones.std():.3f}")
Ajustar los hiperparámetros
from sklearn.model_selection import GridSearchCV

busqueda = GridSearchCV(
    modelo,
    param_grid={"logisticregression__C": [0.01, 0.1, 1, 10]},
    cv=5,
    scoring="f1",
)
busqueda.fit(X_train, y_train)
print(busqueda.best_params_, round(busqueda.best_score_, 3))
Guardar el modelo
import joblib

joblib.dump(busqueda.best_estimator_, "modelo.joblib")
modelo_cargado = joblib.load("modelo.joblib")
Por qué usar pipelines
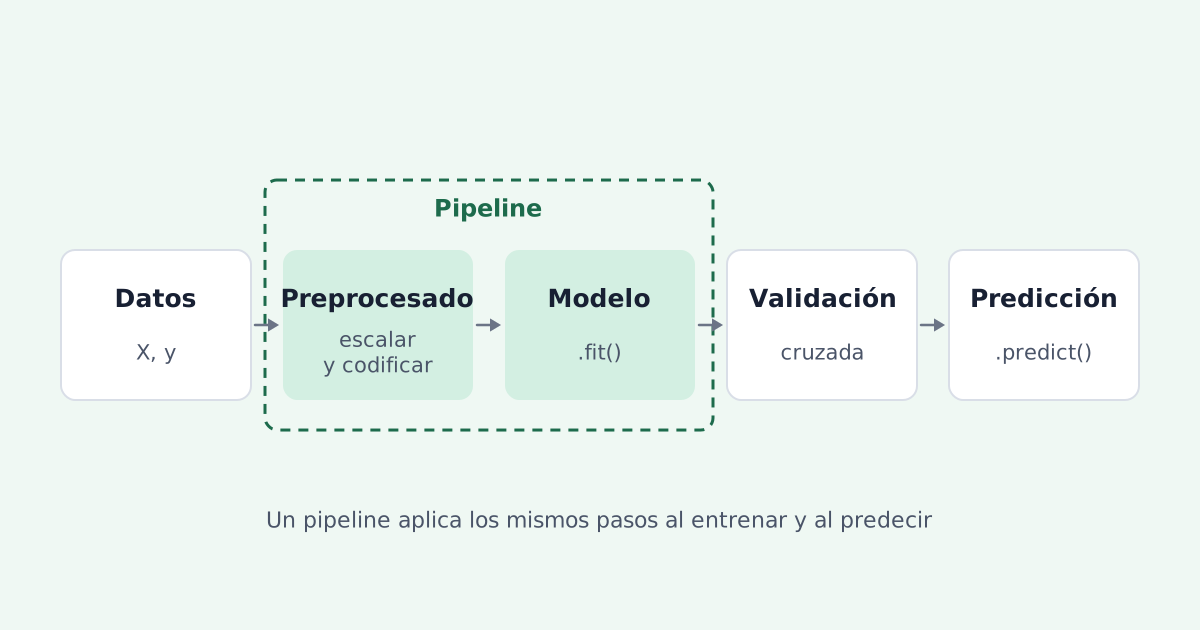
En el ejemplo, el escalado y el modelo van juntos en un Pipeline. No es un detalle estético: así el escalado se calcula solo con los datos de entrenamiento de cada partición y se evita la fuga de datos, uno de los errores más frecuentes, que hace que un modelo parezca mucho mejor de lo que es. Además, guardas un único objeto que aplica todo el preprocesado al predecir con datos nuevos.
Scikit-learn y el resto del ecosistema
- Para datos tabulares grandes, librerías como XGBoost o LightGBM ofrecen gradient boosting muy eficiente con una interfaz compatible.
- Para redes neuronales, el paso natural es PyTorch.
- Para poner el modelo en producción se combina con herramientas de despliegue, seguimiento de experimentos y monitorización.
¿Sigue teniendo sentido el machine learning clásico?
Sí. Con datos tabulares, como transacciones, sensores o historiales de clientes, un modelo de scikit-learn suele ser más barato, más rápido y más fácil de explicar que un modelo de lenguaje. La IA generativa destaca con texto, imágenes y documentos. Un buen profesional sabe cuándo usar cada cosa, como contamos en el impacto de la IA en la ciencia de datos.