Una de las primeras dudas de quien quiere dedicarse a la ciencia de datos o a la inteligencia artificial es qué lenguaje aprender. La respuesta corta: Python y SQL, en ese orden. Después, según el sector y el tipo de trabajo, R, Scala, Julia u otros. Vemos para qué sirve cada uno y cómo organizar el aprendizaje.
Python: el lenguaje común de los datos y la IA
Python es hoy el lenguaje más usado en ciencia de datos y aprendizaje automático. Su sintaxis es sencilla, se lee casi como pseudocódigo y, sobre todo, tiene el ecosistema más completo:
- pandas y Polars para manipular datos.
- NumPy y SciPy para cálculo numérico.
- scikit-learn para aprendizaje automático clásico.
- PyTorch para redes neuronales.
- Hugging Face Transformers para modelos de lenguaje y visión.
- Las librerías de los proveedores de modelos de lenguaje y los frameworks para construir agentes y sistemas RAG.
Además, Python sirve para todo el ciclo: explorar en un notebook, construir una API y desplegarla en producción. Si empiezas, empieza por aquí. En nuestra guía de pandas tienes los primeros pasos.
SQL: donde viven los datos
La mayoría de los datos de una organización están en bases de datos relacionales o en almacenes de datos en la nube. SQL es la forma de consultarlos, y lo vas a usar a diario sea cual sea tu perfil. Aprender bien uniones, agregaciones, subconsultas y funciones de ventana marca la diferencia. Herramientas como DuckDB permiten además usar SQL directamente sobre ficheros desde Python.
R: estadística e investigación
R nació para la estadística y sigue siendo muy fuerte en bioestadística, epidemiología, economía e investigación académica. El ecosistema tidyverse hace muy cómodo el análisis de datos, ggplot2 produce gráficos de calidad de publicación y Shiny permite crear aplicaciones web interactivas. Si trabajas en esos ámbitos, R es una gran elección.
Otros lenguajes y cuándo tienen sentido
- Scala y Java: en ingeniería de datos a gran escala, por ejemplo con Apache Spark.
- Julia: cálculo científico de alto rendimiento con una sintaxis cómoda, con un ecosistema más pequeño.
- MATLAB: muy presente en ingeniería y tratamiento de señal, menos en la empresa orientada a datos.
- C++ y Rust: para optimizar el rendimiento y en los motores que ejecutan los modelos. No son para empezar, pero están detrás de muchas librerías que usas desde Python.
- JavaScript o TypeScript: para llevar modelos y visualizaciones al navegador o integrar IA en aplicaciones web.
Resumen
| Lenguaje | Uso principal | Cuándo aprenderlo |
|---|---|---|
| Python | Análisis, machine learning, IA generativa, producción | Primero |
| SQL | Consultar y preparar datos | Primero, en paralelo a Python |
| R | Estadística, investigación, bioestadística | Si tu sector lo usa |
| Scala o Java | Ingeniería de datos con Spark | Si vas a ingeniería de datos |
| Julia | Cálculo científico | Por necesidad concreta |
| C++ o Rust | Rendimiento, motores de inferencia | Más adelante, si te especializas |
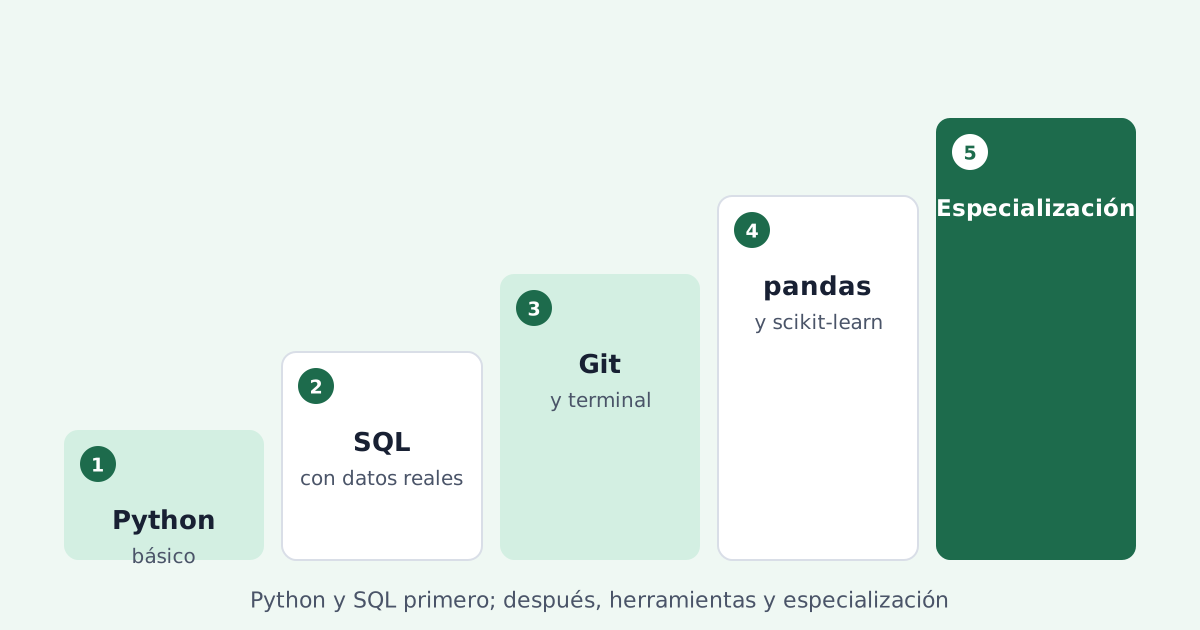
En qué orden aprender
- Python básico: tipos, funciones, estructuras de datos y entornos virtuales.
- SQL, en paralelo, con datos reales.
- Git y la línea de comandos, imprescindibles para trabajar en equipo y para usar agentes de código.
- pandas, visualización y scikit-learn con proyectos propios.
- Especialización: deep learning, modelos de lenguaje, ingeniería de datos o el área que te interese.
¿Con agentes de código sigue haciendo falta aprender a programar?
Sí, y más que antes. Un agente de código puede escribir buena parte del código por ti, pero alguien tiene que explicarle qué construir, darle el contexto adecuado y revisar lo que produce. Quien entiende el código saca mucho más partido al agente; quien no lo entiende acepta errores sin darse cuenta.