El data analytics consiste en convertir datos en decisiones: descubrir qué está pasando, entender por qué y anticipar qué conviene hacer. Puede sonar abstracto, pero está detrás de servicios que usamos a diario. Estos siete casos reales muestran qué problema resolvía cada uno y qué técnica había detrás.
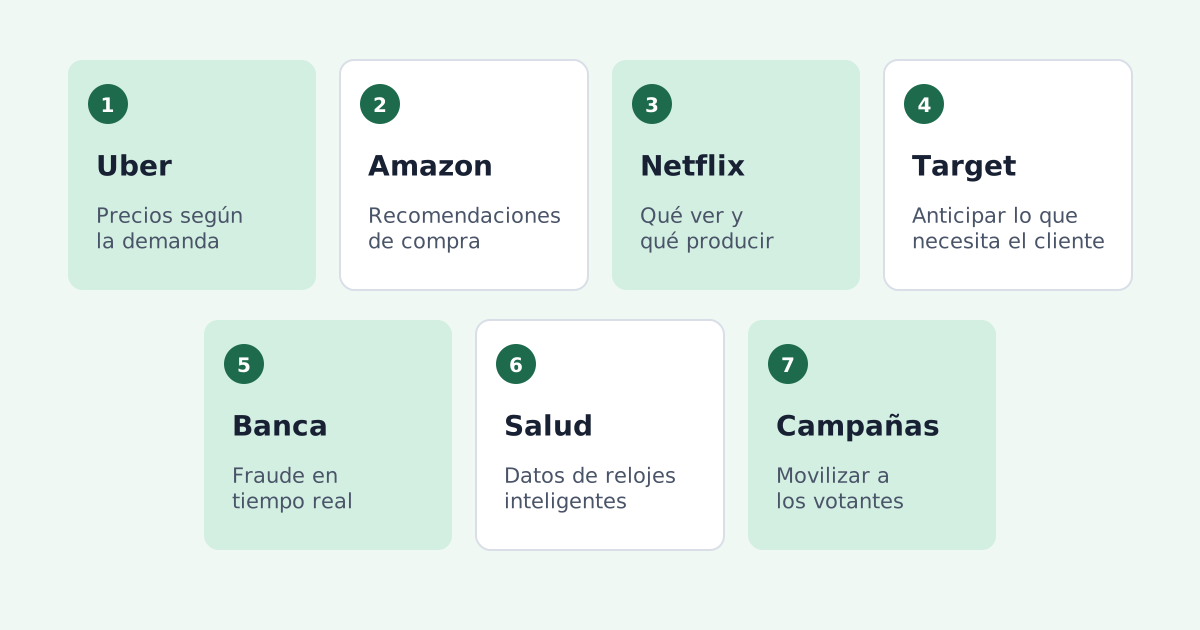
1. Uber: precios que se ajustan a la demanda
Cuando muchos usuarios piden coche a la vez en una zona y hay pocos conductores, el precio sube. Es la tarificación dinámica de Uber, que cruza en tiempo real la demanda de viajes, la posición de los conductores, la hora y los eventos de la ciudad. El objetivo es doble: que haya coches disponibles y que los conductores se desplacen a las zonas con más demanda.
Qué hay detrás: análisis geoespacial, previsión de demanda a muy corto plazo y modelos de optimización.
2. Amazon: "los clientes que compraron esto también compraron…"
Las recomendaciones de Amazon son uno de los ejemplos más citados de análisis de datos aplicado. En lugar de comparar clientes entre sí, su sistema relaciona productos que suelen comprarse o verse juntos, un enfoque llamado filtrado colaborativo item-to-item que la propia compañía describió en un artículo de 2003. Escala a millones de productos y se actualiza con cada compra.
Qué hay detrás: filtrado colaborativo, análisis de cesta de la compra y pruebas A/B para medir qué recomendación funciona mejor.
3. Netflix: qué ver… y qué producir
Netflix personaliza casi todo lo que ves: el orden de las filas, los títulos que aparecen e incluso la imagen de portada de cada serie, que cambia según lo que suele gustarte. Entre 2006 y 2009 llegó a organizar el Netflix Prize, un concurso con un millón de dólares de premio para quien mejorase su algoritmo de recomendación en un 10 %. Los datos de visionado también informan qué contenidos comprar o producir.
Qué hay detrás: sistemas de recomendación, experimentación continua y análisis del comportamiento de visionado.
4. Target: anticiparse a lo que necesita el cliente
En 2012, un reportaje de The New York Times contó cómo la cadena estadounidense Target analizaba el historial de compras para estimar qué clientas estaban embarazadas y enviarles ofertas de productos para bebés. El caso se convirtió en el ejemplo clásico de la potencia del análisis predictivo… y de sus riesgos para la privacidad.
Qué hay detrás: modelos predictivos sobre datos de compra. La lección: que algo sea técnicamente posible no significa que sea aceptable. Hoy, en Europa, el RGPD limita este tipo de tratamientos.
5. Banca: detectar el fraude en tiempo real
Cada vez que pagas con tarjeta, el banco decide en milisegundos si la operación es legítima. Compara el importe, el comercio, el lugar y la hora con tu comportamiento habitual y con patrones de fraude conocidos. Si algo no encaja, bloquea el pago o te pide una confirmación.
Qué hay detrás: detección de anomalías, modelos de clasificación entrenados con fraudes anteriores y reglas de negocio.
6. Salud: los datos de los relojes inteligentes
Los relojes y pulseras de actividad registran pasos, pulso, sueño o ejercicio, y ofrecen a cada usuario un resumen de su salud. A gran escala, esos datos sirven también para investigar. El Apple Heart Study, de la Universidad de Stanford, analizó datos de cientos de miles de participantes para evaluar si el reloj podía detectar un pulso irregular asociado a la fibrilación auricular.
Qué hay detrás: procesamiento de señales, detección de patrones y estudios clínicos con datos del mundo real. Ampliamos este campo en análisis de datos e IA en medicina.
7. Campañas electorales: la reelección de Obama en 2012
La campaña de Barack Obama en 2012 montó un equipo de analítica que estimaba, votante a votante, la probabilidad de apoyar al candidato y de ir a votar. Con esa información decidía a quién llamar, qué mensaje enviar y por qué canal, y medía el efecto de cada acción con experimentos.
Qué hay detrás: segmentación, modelos de propensión y experimentos controlados.
Qué tienen en común
| Caso | Pregunta | Técnica principal |
|---|---|---|
| Uber | ¿Qué precio equilibra oferta y demanda ahora? | Previsión y optimización |
| Amazon | ¿Qué más le interesará a este cliente? | Filtrado colaborativo |
| Netflix | ¿Qué le enseñamos a cada usuario? | Sistemas de recomendación |
| Target | ¿Qué necesitará este cliente pronto? | Modelos predictivos |
| Banca | ¿Es fraudulenta esta operación? | Detección de anomalías |
| Salud | ¿Hay un patrón que indique un problema? | Análisis de señales |
| Obama 2012 | ¿A quién contactar y con qué mensaje? | Modelos de propensión |
En todos los casos el punto de partida no fue la tecnología, sino una pregunta de negocio clara y datos fiables para responderla. Y en todos hubo una forma de medir si la decisión basada en datos funcionaba mejor que la anterior.
Cómo empezar a aplicarlo en tu organización
- Elige una decisión que se repita a menudo y que hoy se tome por intuición.
- Comprueba qué datos tienes y si son fiables.
- Empieza por un análisis descriptivo sencillo antes de construir modelos.
- Mide el resultado frente a la forma anterior de decidir.
Si te interesa ver la diferencia entre este enfoque y la ciencia de datos, la explicamos en Data Science vs Data Analytics.